文章发了几天在谷歌里搜不到,先别反复点「请求编入索引」。更快的做法是先做谷歌收录查询:在 Google Search Console(GSC)按顺序查 5 项——用网址检查确认真实状态,看未编入索引属于哪个原因,分清「已发现」和「已抓取」,用「测试实际网址」排除 noindex、robots.txt、规范网址等技术阻碍,最后看 sitemap 和内链有没有给 Google 足够的理由来抓。
下面拿我之前发过的一篇文章做例子。它在 sitemap 里,页面本身也能被编入索引,但 GSC 显示它还没有被收录。文中截图都来自 sufob.com 的 GSC 资源。
适合谁:独立站运营、SEO 执行、自己维护博客的站长。文章已经发布,但在谷歌里搜不到。 需要准备:GSC 资源的访问权限。只有资源的拥有者或完整权限用户,才能在网址检查里请求编入索引。
先看清单:5 项按顺序查
| # | 查什么 | 在 GSC 哪里看 | 看到什么算正常 |
|---|---|---|---|
| 1 | 这篇到底收没收录 | 顶部的网址检查 | 「网址已收录到 Google」 |
| 2 | 没收录属于哪一类原因 | 编制索引 → 网页 | 原因的「来源」是「网站」还是「Google 系统」 |
| 3 | 卡在抓取前还是抓取后 | 网址检查 → 网页索引编制 | 分清「已发现」和「已抓取」 |
| 4 | 页面本身能不能被编入索引 | 网址检查 → 测试实际网址;设置 → robots.txt | 「网址可编入 Google 索引」 |
| 5 | Google 有没有理由来抓 | 编制索引 → 站点地图;网址检查 → 发现 | sitemap 状态「成功」,引荐来源里有正常的文章页 |
第 1 项:用网址检查确认收录状态,不要只靠 site:
很多人的第一反应是在谷歌搜 site: 加网址。这个方法可以参考,但不能当结论。Google 对 site: 的说明是:已编入索引的网址可以出现在 site: 结果里,但不保证;搜不到时,应该用网址检查工具确认(Google:site: 搜索运算符说明)。同一份文档还提醒,site:https://www.example.com 和 site:https://example.com/ 返回的结果不一样,带不带 www 要和你的实际网址一致。
正确的做法是在 GSC 顶部的搜索框里输入完整网址,回车。
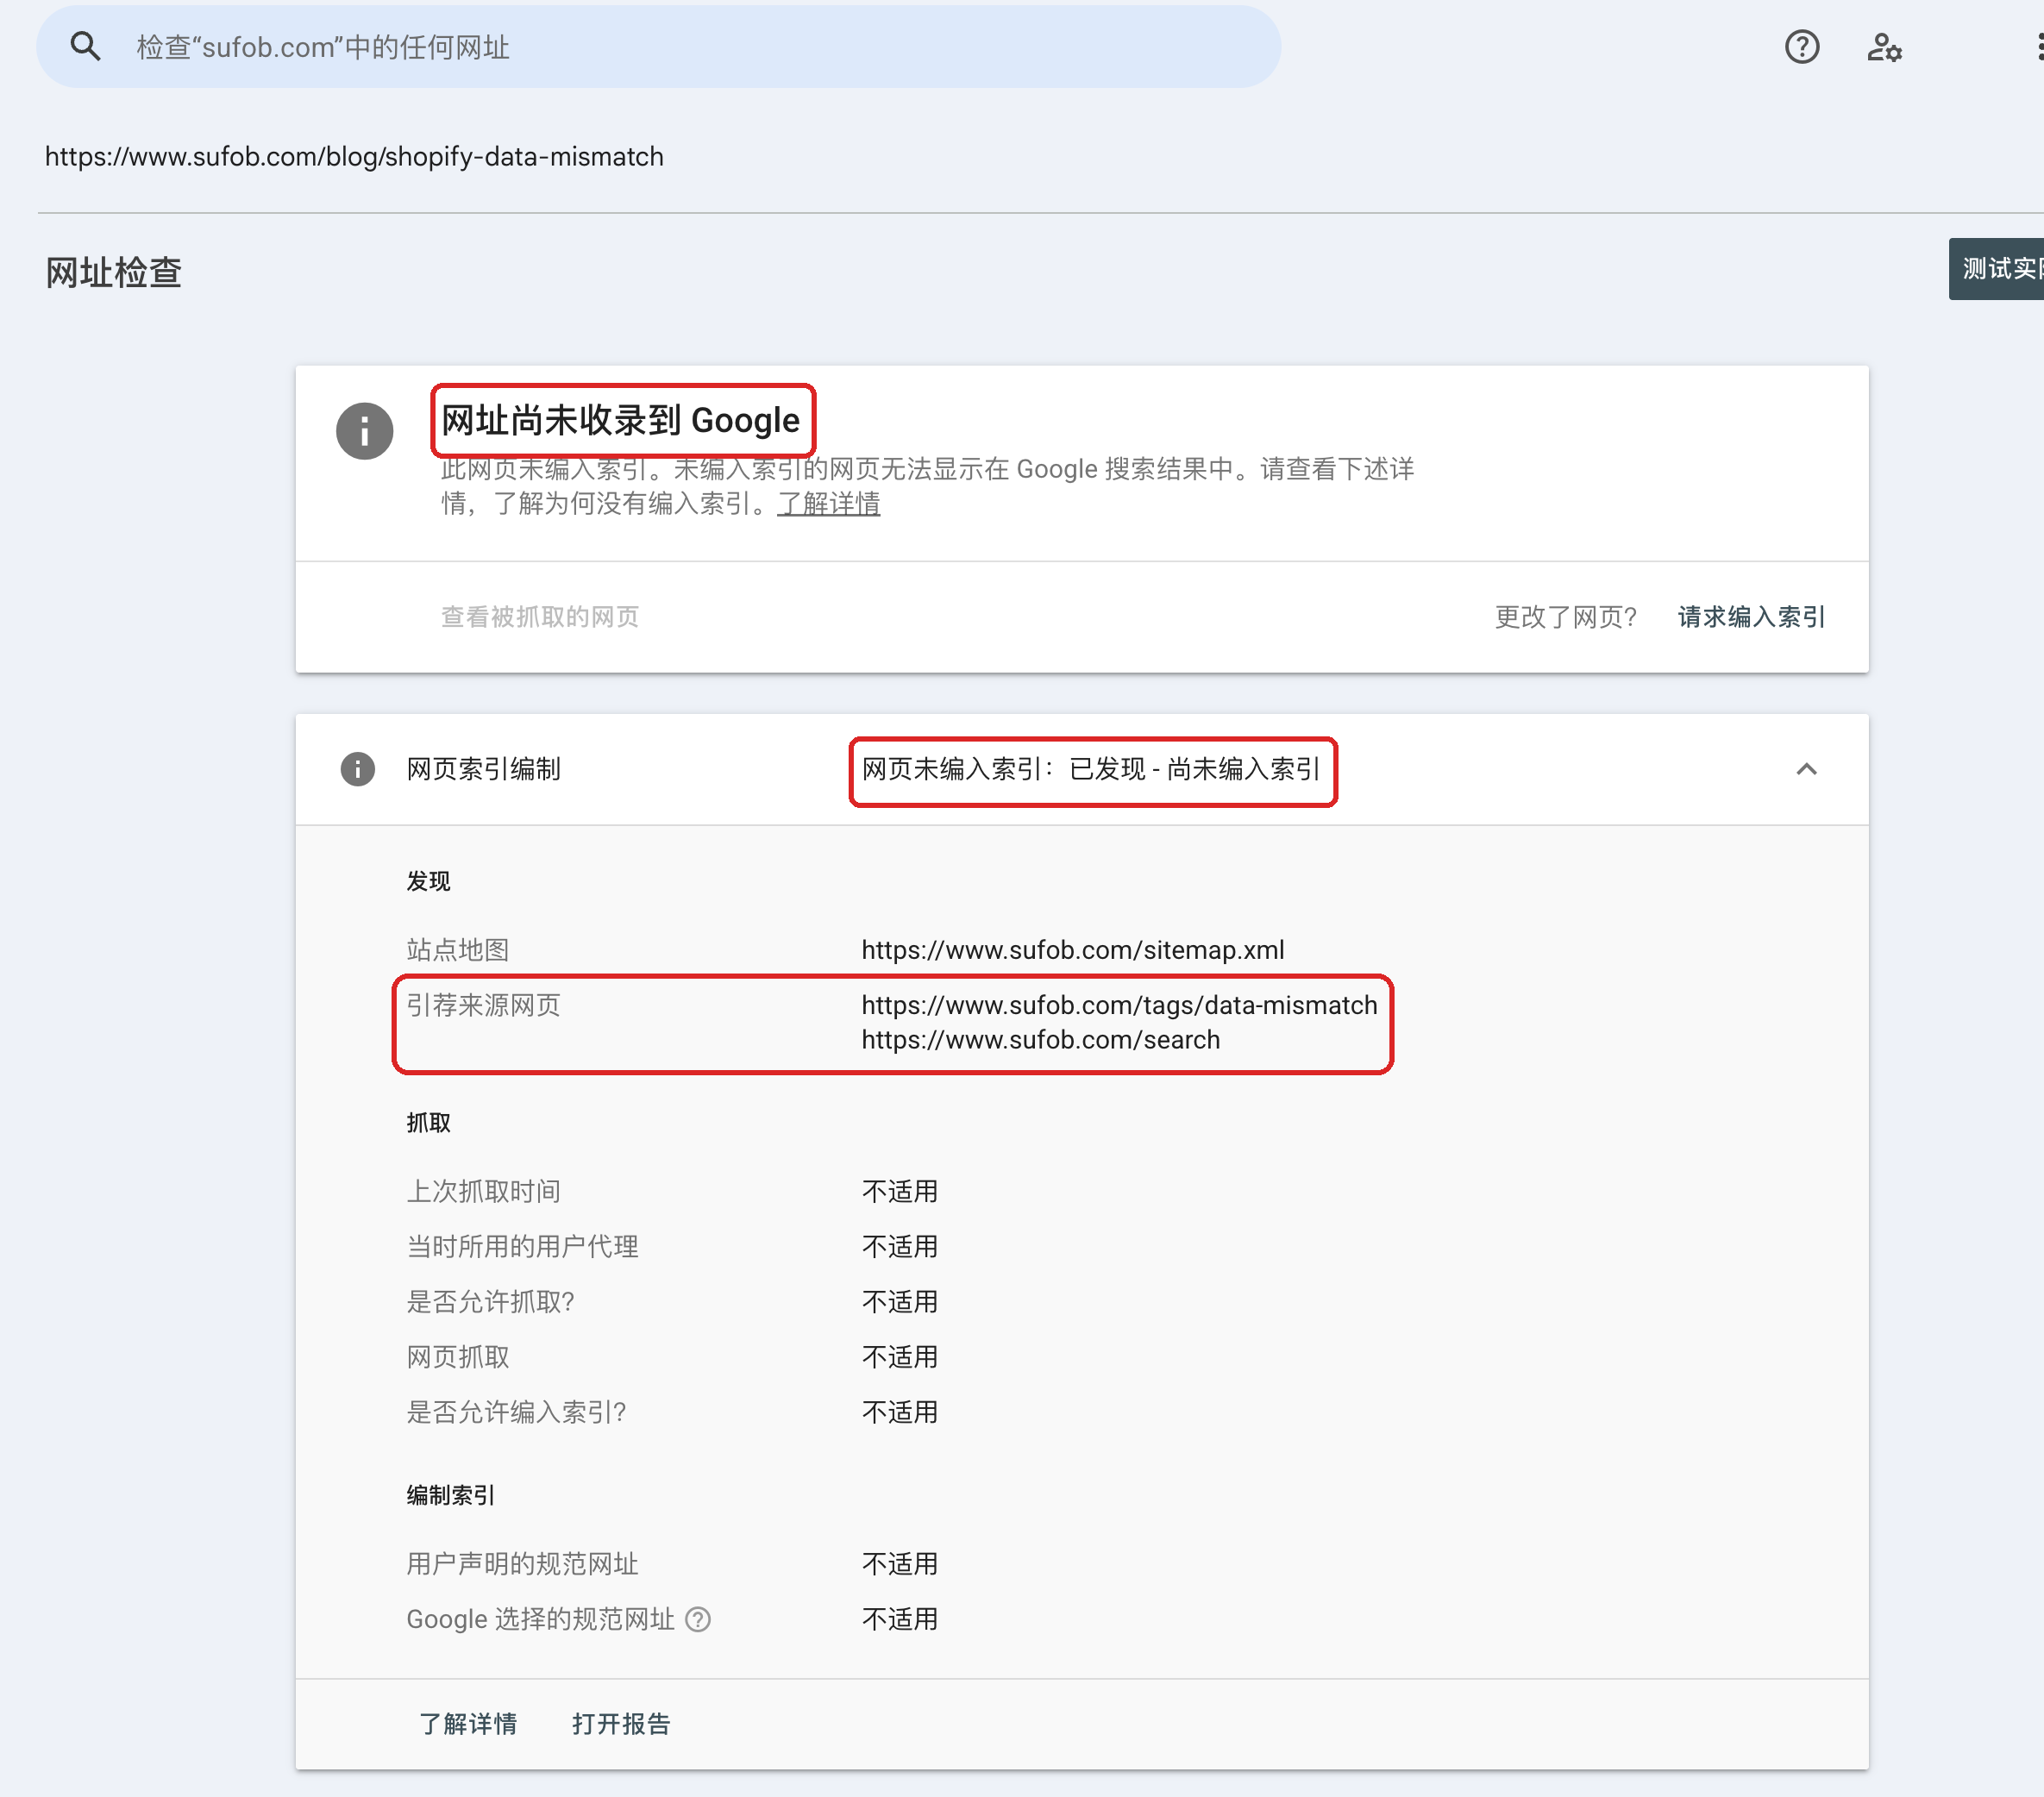
我拿站上这篇讲 Shopify、GA4 和广告后台三方数字差异 的文章做例子。网址检查的结果是:
网址尚未收录到 Google 网页未编入索引:已发现 - 尚未编入索引
拿我已收录的那篇对照:我之前写的 Meta CAPI 事件去重,结果是「网址已收录到 Google」「网页已编入索引」。
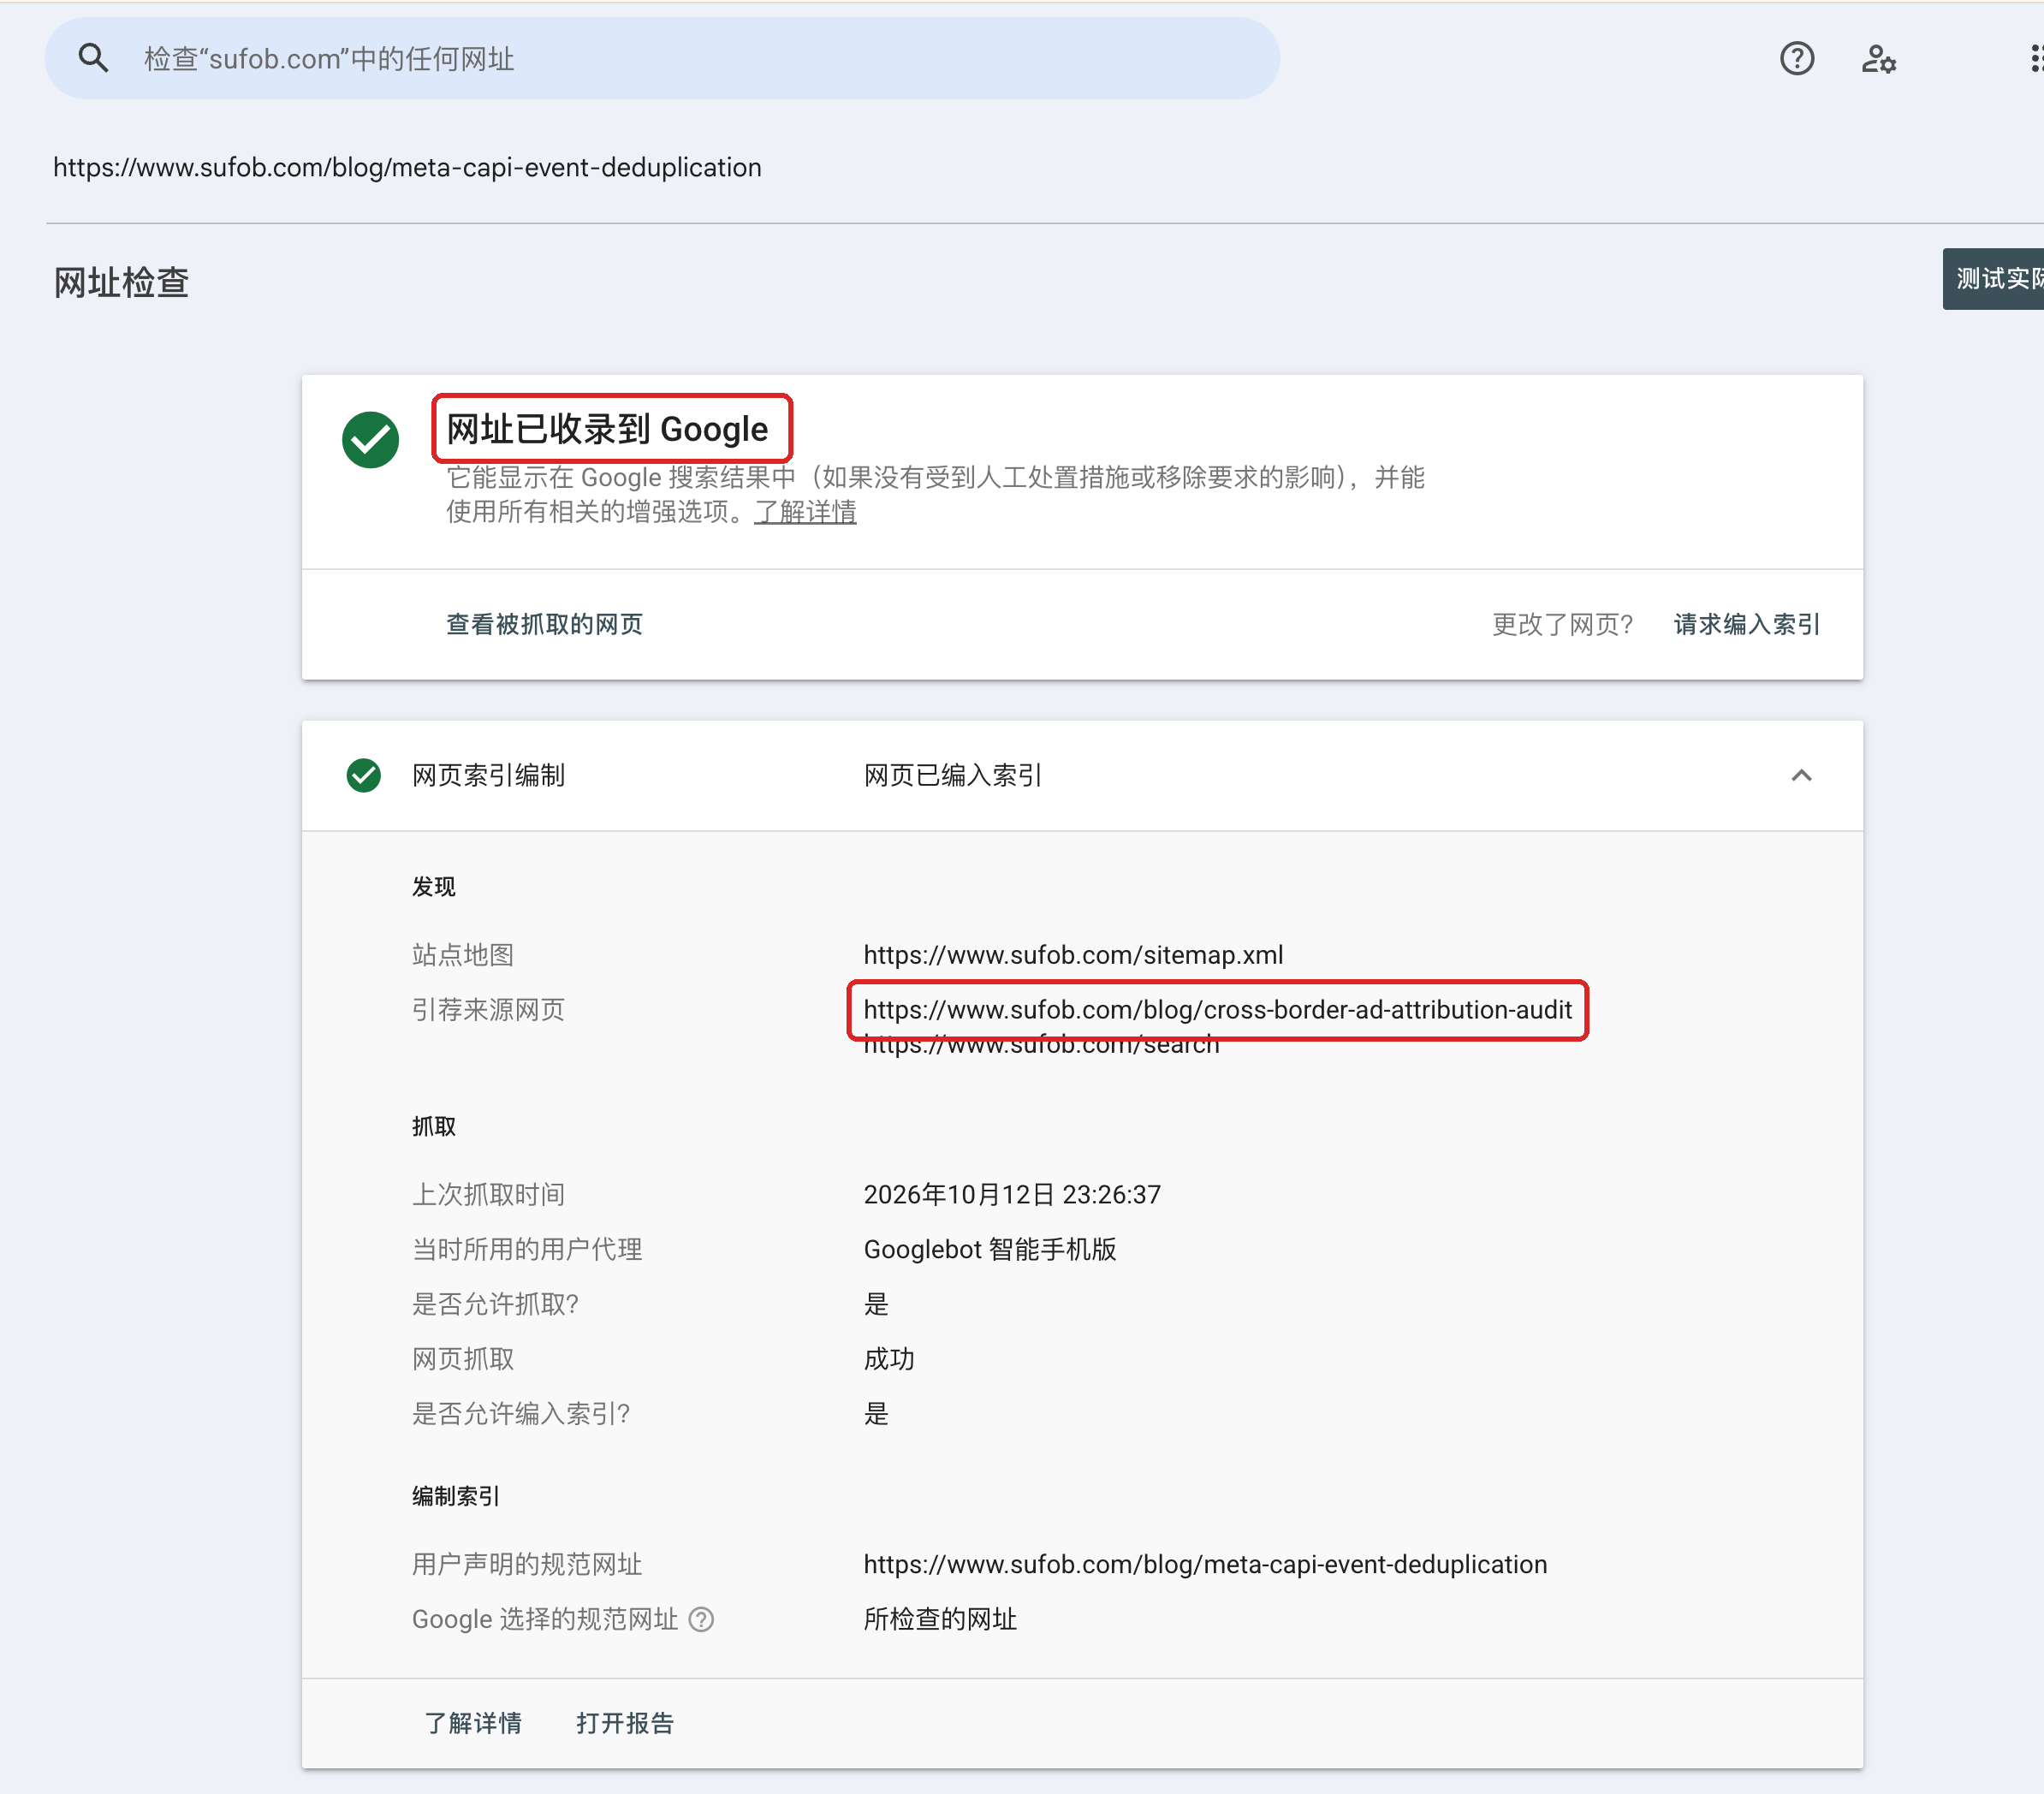
为什么要拿我已收录的那篇对照:同一个站、同一个 sitemap,一篇收了、一篇没收,就可以先排除「整站被屏蔽」这类大问题,把注意力放在这一篇和别的文章有什么不同上。第 5 项会再用到这组对照。
第 2 项:看网页索引编制报告,分清原因来自网站还是 Google
单篇查完,再去「编制索引 → 网页」看全站。sufob.com 这份报告的上次更新日期是 2026/10/12,筛选条件是「所有已知网页」:「未编入索引」127,「已编入索引」99。
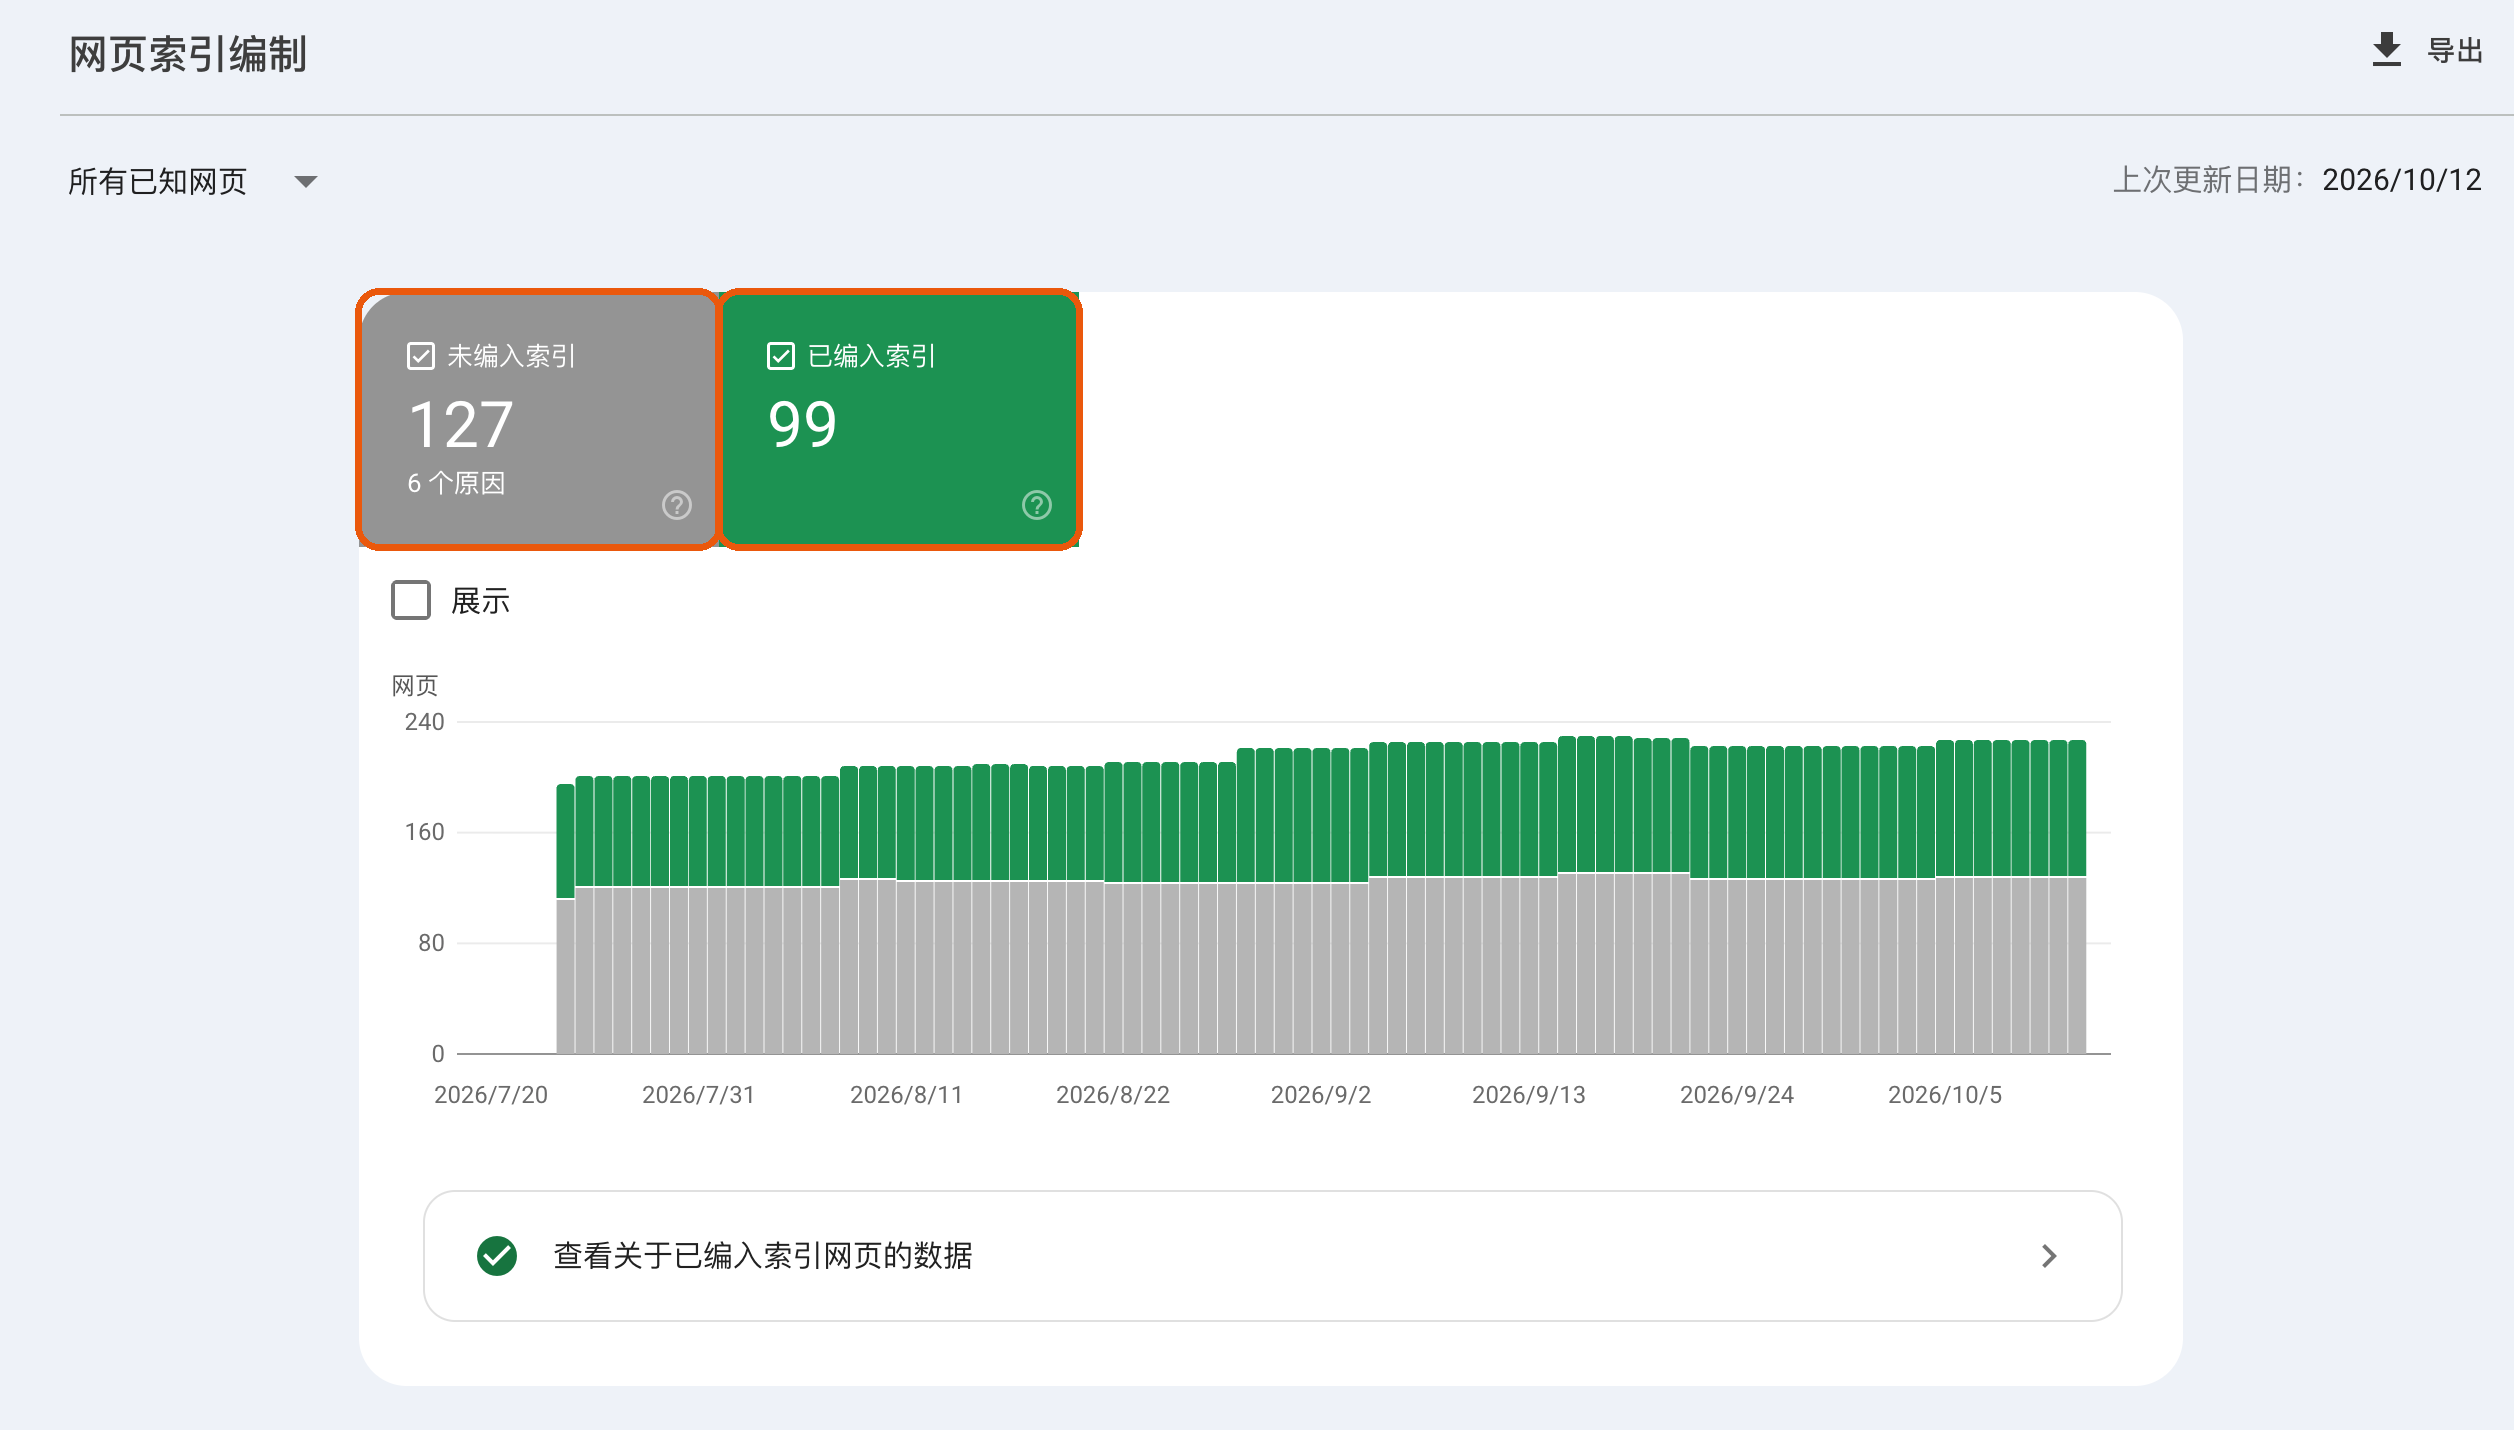
未编入索引比已编入索引还多,看起来吓人,但未编入索引不等于出了问题。往下滚到「网页未被编入索引的原因」,sufob.com 一共有 6 个原因:
| 原因(GSC 原文) | 来源 | 网页 |
|---|---|---|
| 被"noindex"标记排除了 | 网站 | 60 |
| 未找到 (404) | 网站 | 34 |
| 网页会自动重定向 | 网站 | 20 |
| 重复网页,用户未选定规范网页 | 网站 | 4 |
| 已抓取 - 尚未编入索引 | Google 系统 | 8 |
| 已发现 - 尚未编入索引 | Google 系统 | 1 |
6 行相加正好是 127。
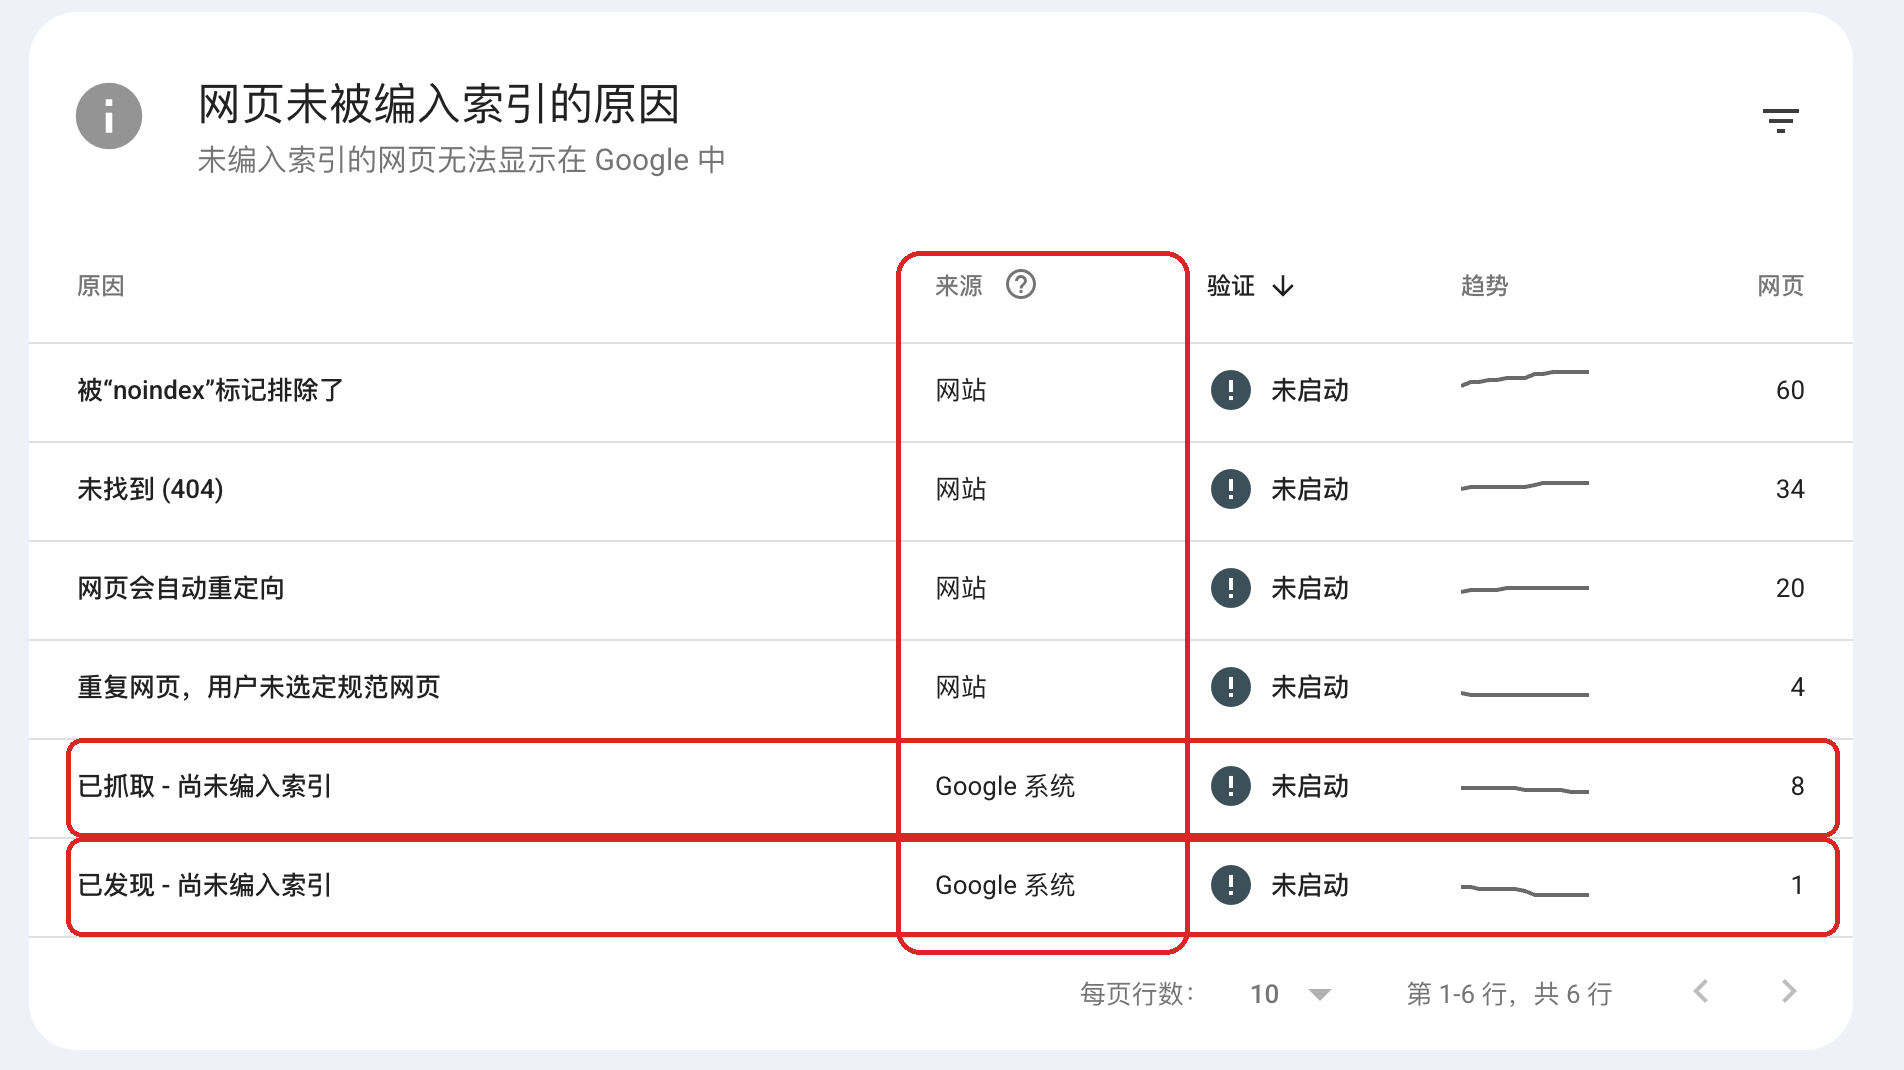
这张表重点看「来源」这一列。Google 的帮助文档说,一般来说,只有来源是「网站」的问题才是你能直接修的(Google:网页索引编制报告说明)。每一类的意思如下:
- 被"noindex"标记排除了:页面主动告诉 Google 不要收录。标签页、站内搜索页这类不需要出现在搜索结果里的页面,本来就该在这里。要查的是,有没有你想被收录的文章误加了 noindex。
- 未找到 (404):按 Google 文档的说法,页面删掉了又没有替代页时,404 不一定是问题;如果页面换了地址,用 301 重定向到新地址。
- 网页会自动重定向:跳转前的网址不会被编入索引,这通常是正常的。跳转后的目标网址收不收录,要单独看。
- 重复网页,用户未选定规范网页:Google 认为它和另一个页面重复,自己选了另一个页面作为规范网页。可以用网址检查看 Google 选的是哪一个。
- 已抓取 / 已发现 - 尚未编入索引:来源是「Google 系统」,不是改一个设置就能解决的,下面分开讲。
排查顺序:先点进来源是「网站」的几个原因,确认里面没有你想被收录的页面;再看「Google 系统」的两类里有没有你的重点文章。
第 3 项:分清「已发现」和「已抓取」,两者卡在不同环节
这两个状态名字很像,但卡在不同的环节:「已发现」是 Google 还没来抓,「已抓取」是 Google 来过但暂时没收。
「已发现 - 尚未编入索引」,Google 文档的解释是:网页已经被 Google 找到,但还没有抓取;通常是 Google 本来想抓,但预计会让网站负载过重,于是改了抓取时间,所以报告里的上次抓取日期是空的(来源同上)。
我这篇 /blog/shopify-data-mismatch 就是这个状态。网址检查里,「上次抓取时间」「是否允许抓取?」「网页抓取」「是否允许编入索引?」都显示「不适用」,「用户声明的规范网址」「Google 选择的规范网址」也是「不适用」。也就是说,Google 还没有真正打开过这个页面。
这种情况下,Google 还没看到正文,所以先不用急着改内容,重点放在第 4、5 项:确认页面能被抓取,并让 Google 更容易、更有理由来抓。
如果是「已抓取」,情况就不同了,见下一节。
「已抓取 - 尚未编入索引」是什么意思,要不要处理
Google 文档的解释是:网页已经被 Google 抓取,但没有编入索引;将来可能会被编入索引,也可能不会;不需要为了抓取重新提交这个网址(来源同上)。
sufob.com 这一类下有 8 个网址。点进这个原因,能看到「示例」列表,每个网址都带「上次抓取日期」:
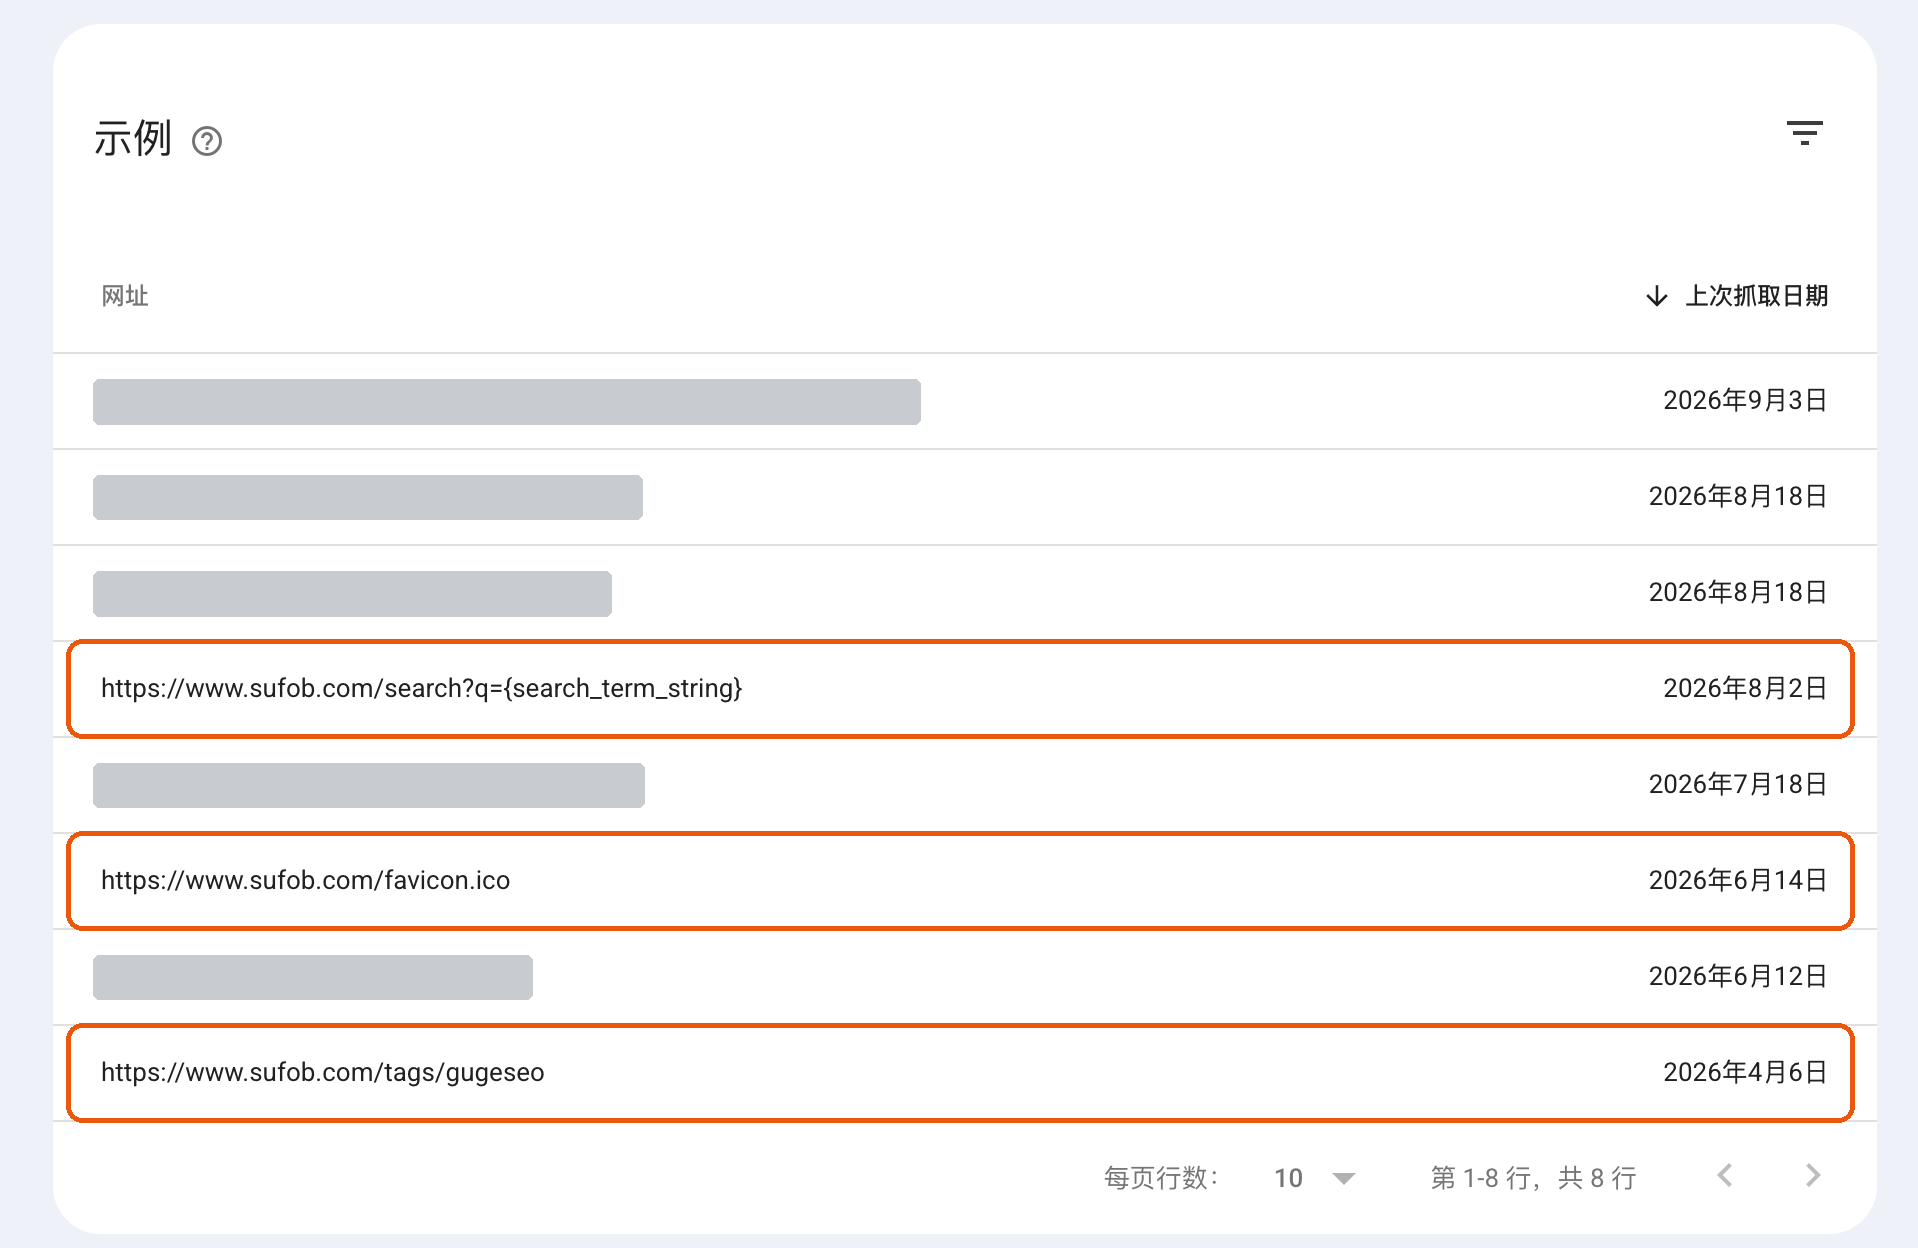
这 8 条里能直接看到的有:
/search?q={search_term_string}:站内搜索的网址模板,不是一个真实页面/favicon.ico:网站图标文件/tags/gugeseo:一个标签页
其余 5 条在图里打了码,也都不是文章页。所以对 sufob.com 来说,这 8 条暂时不用处理,它们本来就不需要靠谷歌搜索带来访问。
判断方法是点进这个原因,逐条问自己:这个页面,我希望用户从谷歌搜到吗?
- 不希望:可以不管。如果页面确实不该出现在搜索结果里,也可以加 noindex,让它归到「被"noindex"标记排除了」那一类,报告会更清楚。
- 希望,比如这是一篇正式文章:收不收录由 Google 的系统决定,你能做的是让页面更值得收录。可以从三个方向检查:这篇是否独立回答了一个明确的问题;站内是否已经有意图高度相似的文章;有没有正常的文章页链向它。改完再请求编入索引。
第 4 项:用测试实际网址和 robots.txt 报告,排除技术阻碍
网址检查默认显示的是 Google 索引里已有的记录。点右上角的「测试实际网址」,GSC 会立刻抓取一次你现在线上的页面,告诉你此刻它能不能被编入索引。
我对 /blog/shopify-data-mismatch 做了实际测试,测试时间是 2026年10月18日 13:16,结果是:
网址可编入 Google 索引 网页可用性:网页可以编入索引
「增强功能和体验」下的「路径」(GSC 中文界面里面包屑导航的叫法)显示「检测到了 1 项有效内容」。
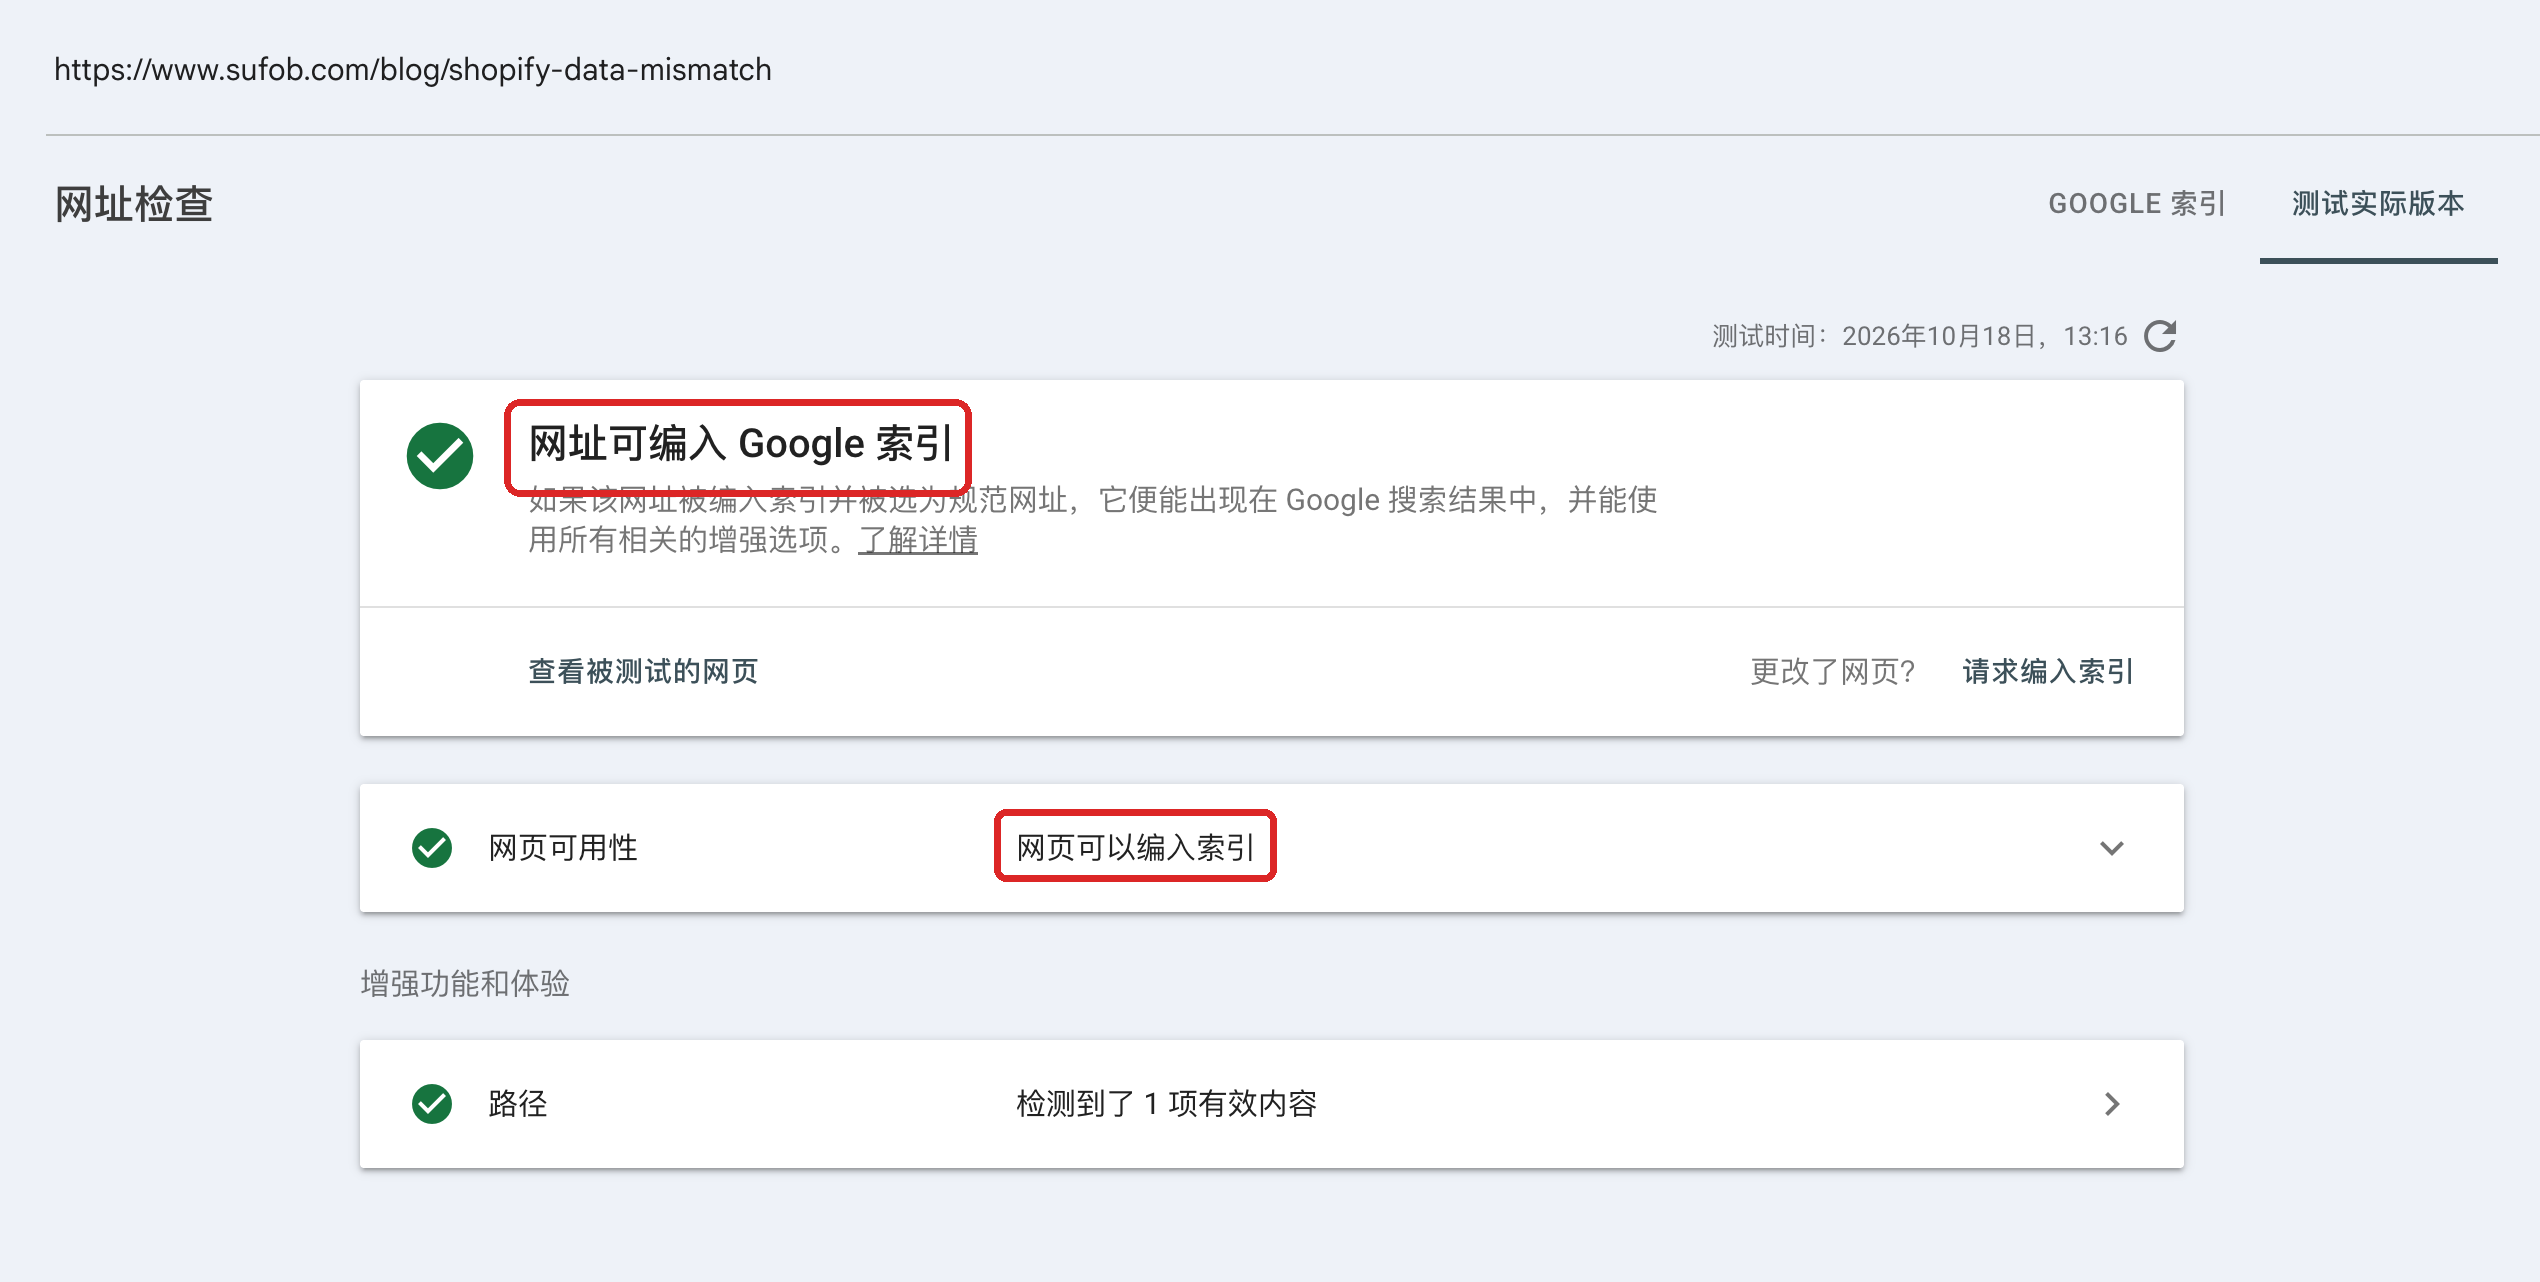
如果你的测试结果不是这样,按下面几项逐个查:
- noindex:在网址检查里看「是否允许编入索引?」。Google 文档建议在页面源代码或 HTTP 响应头里搜 noindex,再用测试实际网址确认线上版本是否还带着 noindex。
- robots.txt:在「设置 → robots.txt」看 GSC 抓到的 robots.txt 状态。sufob.com 的 http、https、带 www、不带 www 四个版本状态都是「已提取」,问题数量是「-」。
- 规范网址:在网址检查的「编制索引」部分,对比「用户声明的规范网址」和「Google 选择的规范网址」。拿我已收录的 meta-capi-event-deduplication 对照:声明的是它自己,Google 选择的是「所检查的网址」,两者一致,这是正常状态。
- 404 和跳转:确认你检查的是最终网址,而不是一个会跳转的旧网址。
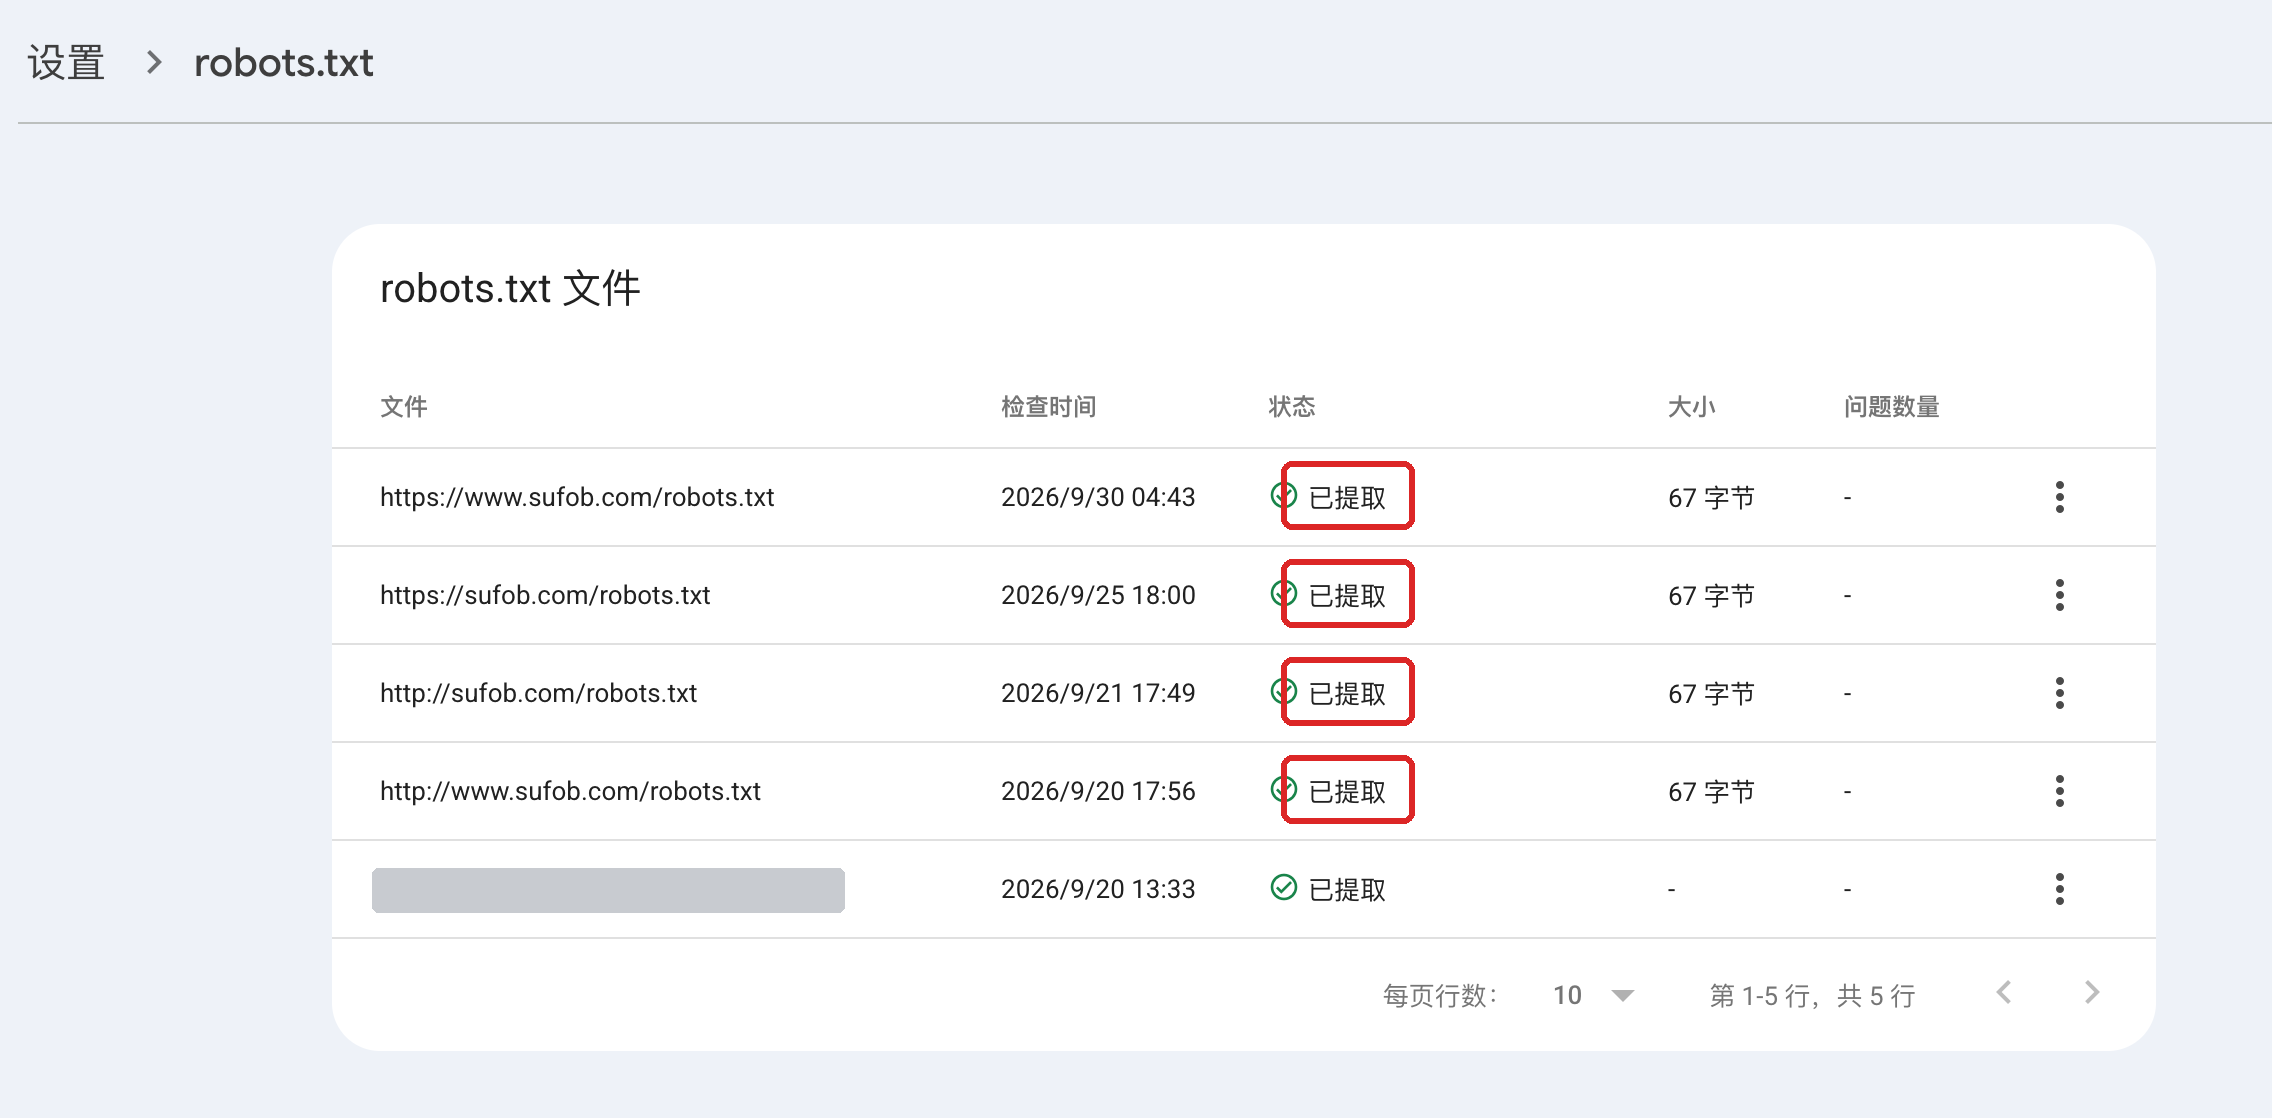
注意日期:测试实际网址反映的是测试那一刻的线上页面,而网页索引编制报告的数据有自己的更新日期,sufob.com 这份是 2026/10/12。两边结果不同时,先看日期。
到这一步,我这篇还没收录的文章情况就清楚了:页面本身没有技术阻碍,只是 Google 还没有来抓。
第 5 项:检查 sitemap 和内链,给 Google 来抓的理由
技术上能抓,不等于 Google 会优先来抓。最后一项看 Google 发现这个网址的两条途径。
sitemap:确认已提交、读取成功
在「编制索引 → 站点地图」看 sitemap 的状态。sufob.com 提交的 https://www.sufob.com/sitemap.xml 状态是「成功」,上次读取时间是 2026年10月11日,「已发现的网页」是 90。
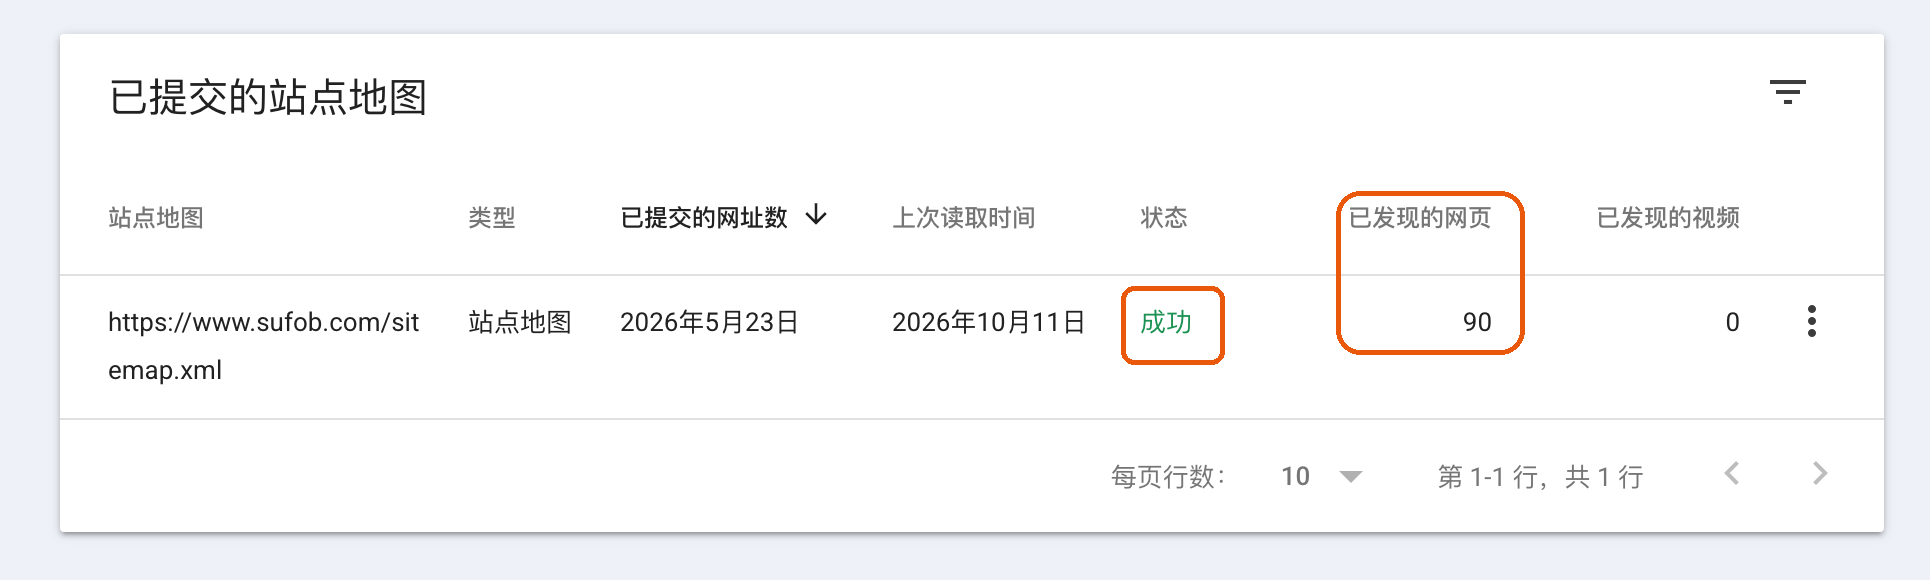
网址检查的「发现」部分也显示,/blog/shopify-data-mismatch 是通过这个 sitemap 被发现的。sitemap 的作用是让 Google 知道这个网址存在,这一步这篇文章已经做到了。
内链:看「引荐来源网页」里有没有正常的文章页
这一项最能体现拿我已收录那篇对照的价值。两篇文章在网址检查「发现」部分的记录:
| /blog/shopify-data-mismatch(我还没收录) | /blog/meta-capi-event-deduplication(我已收录) | |
|---|---|---|
| 站点地图 | https://www.sufob.com/sitemap.xml | https://www.sufob.com/sitemap.xml |
| 引荐来源网页 | /tags/data-mismatch、/search | /blog/cross-border-ad-attribution-audit、/search |
我还没收录的那篇,引荐来源只有一个标签页和站内搜索页,这两个页面目前在线上都设置了 noindex(robots 标签是 noindex, follow)。我已收录的那篇,除了 /search,还有一篇正式文章 跨境独立站广告归因排查清单 链向它。
截图证明不了因果,但这是两篇之间最明显的差别。可能的原因有两个:
- 没有正式文章链向它,Google 不容易判断它在站内有多重要。
- 站内已有讨论相近问题的文章。我站上还有一篇GA4、广告后台和订单后台三方数字的差异分析,两篇讨论的问题有重叠,Google 可能还没把它当成需要单独收录的页面。
对应的做法:
- 在一两篇主题相关、已经被收录的文章里,加一条自然的内链指向它,锚文本写清楚这篇解决什么问题。
- 如果两篇讲的确实是同一个问题,考虑合并,或者改写其中一篇,让每篇回答一个不同的问题。
查完之后,再点「请求编入索引」
5 项都查完、该改的都改了,再在网址检查里点一次「请求编入索引」。Google 文档里有三点值得知道(Google:请求重新抓取网址):
- 抓取可能需要几天到几周;
- 请求抓取不保证会马上出现在搜索结果里,也不保证一定会出现;
- 单个网址的提交有配额,对同一个网址反复请求,不会让它被抓得更快。
所以「请求编入索引」是排查之后的最后一步,不是第一步。提交之后,用网址检查和网页索引编制报告跟踪状态,不用每天去点。
常见问题
文章发布后多久会被谷歌收录?
Google 没有给出固定时间。官方文档的说法是抓取可能需要几天到几周,而且请求抓取不保证收录。与其等一个固定天数,不如发布后先用网址检查确认状态:如果是「已发现 - 尚未编入索引」,按本文第 4、5 项检查技术阻碍和内链。
site: 搜不到,是不是就没收录?
不一定。Google 文档说已编入索引的网址可以出现在 site: 结果里,但不保证,site: 也不一定会列出全部已编入索引的网址。以 GSC 网址检查的结果为准。
「已抓取 - 尚未编入索引」需要重新提交吗?
Google 的说法是不需要为了抓取重新提交。先判断这个页面是否需要被搜到;需要的话,从内容是否独立回答一个问题、站内有没有意图相近的文章、有没有正常的文章内链这三个方向改,改完再请求编入索引。
未编入索引的页面比已编入索引的还多,正常吗?
可能是正常的。sufob.com 未编入索引的 127 个网页里,60 个是被 noindex 主动排除的,34 个是 404,20 个是跳转。总数不是重点,重点是这些原因里有没有你想被收录的页面。
「请求编入索引」可以多点几次吗?
没有用。Google 文档说单个网址的提交有配额,对同一个网址多次请求,不会让它被抓得更快。
下一步
如果你的文章也停在「已发现」或「已抓取 - 尚未编入索引」,先按上面的 5 项清单自查一遍。想把整站的收录、URL 规范和结构化数据一起过一遍,可以看跨境独立站技术 SEO 诊断清单。
如果查完还是找不到原因,需要做一次技术 SEO 诊断,可以准备三样材料:网址检查结果的截图(包括「发现」和「编制索引」两部分)、网页索引编制报告里原因列表的截图、你的 sitemap 地址,然后在跨境极客联系页面提交。
评论
留言需人工审核后才会显示;回复会随主评论一起发布。评论按文章独立归档,请在你阅读的那篇文章下留言。 技术诊断请发邮件 sue@sufob.com或查看联系说明。